
非GPU算力路线开始反攻英伟达 AI推理市场迎来变革。英伟达的“GPU帝国”在AI发展的前十年凭借其在人工智能训练领域的优势稳坐王者宝座。然而,随着行业主战场从模型训练转向模型推理,算力的焦点不再是硬件性能,而是谁能以更优的经济模型支撑海量推理需求。英伟达不再是唯一的规则制定者,而成为众多玩家中的一员。

过去的算力竞赛主要是英伟达不断提升GPU性能的过程。从H100到Blackwell,再到Vera Rubin,每一次迭代都逼近物理极限。但当AI从集中训练走向分散推理时,算力使用逻辑发生了根本变化。推理阶段比训练更频繁、更分散,也更注重能耗与成本。为训练设计的GPU在这一点上显露出天生短板。

GPU以高吞吐率著称,但推理任务往往是串行和实时的。例如ChatGPT每生成一个词,都是一次独立计算。这就像在万人体育场中只允许一个人通行,资源浪费极大。算力闲置带来的能耗与成本,成为AI公司难以承受的“推理税”。

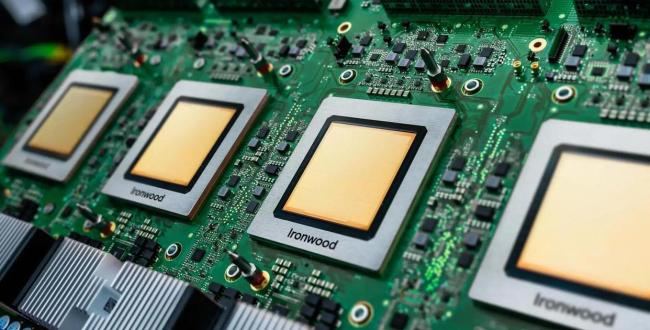
新的硬件革命迅速展开,多种非GPU架构陆续登场,目标一致——降低推理能耗,提升单位经济性。谷歌的TPU早在2016年就已面世,通过“脉动阵列”架构,让数据在芯片内部高效流动,减少访存延迟,比GPU更符合推理需求。同样任务下,TPU的性价比可达英伟达H100的四倍以上,能耗亦能降低约六成。如今,谷歌已将TPU推向公有云,Meta、Anthropic等大客户纷纷采购,传统GPU市场的格局被撼动。
Cerebras则以彻底颠覆的方式出圈。它的晶圆级芯片WSE不再切割成数百个小芯片,而是完整保留整片晶圆,形成一个巨型“单芯片计算机”。这种设计使得大模型的训练和推理都能在单芯片内进行,极大降低通信延迟。WSE-3的能效比GPU集群高出十倍以上,成为OpenAI、Cerebras云服务的核心引擎。
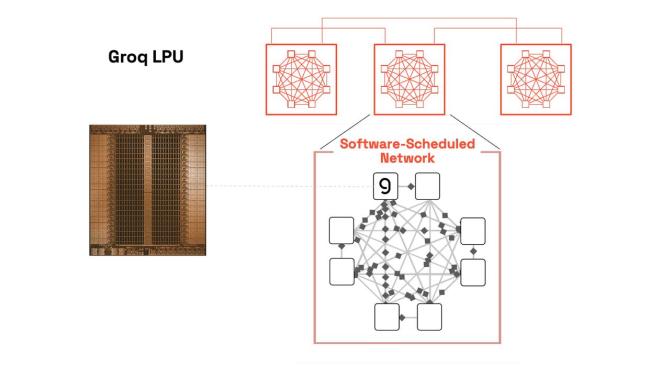
另一家明星企业Groq代表了极端低延迟的方向。其核心产品LPU彻底消除了传统GPU的“动态调度”延迟,所有计算路径在编译阶段就被预先规划,可实现每秒数百个Tokens的推理速度,专为实时AI交互场景设计。
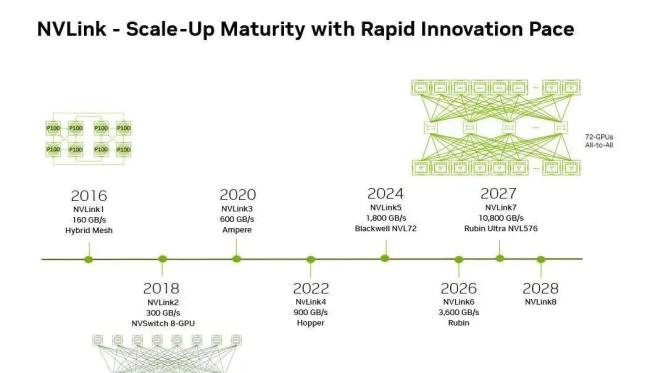
目前,TPU、Cerebras、Groq,再加上AWS的Trainium和微软的Maia,共同构成了崛起的非GPU阵营。AI算力的竞争格局正在从单极走向多元。面对这一局面,英伟达并未退缩。今年,它以200亿美元获得了Groq的非排他性技术许可。这笔交易本质上是一次“智囊招募”,目的在于将LPU的低延迟优势纳入英伟达生态,推动下一代异构架构的融合。未来,英伟达有望推出同时兼具训练与推理功能的复合芯片,以适应日益多样化的市场需求。
AI公司的策略也在变化。OpenAI、Meta、Anthropic都在实践“多架构混合策略”:训练阶段仍依赖CUDA生态完善的GPU,而推理阶段则更多使用TPU、Trainium或Cerebras,以降低成本。这种灵活组合不仅提高了资源利用率,也极大增强了企业的议价能力。
从商业模式上看,算力的售卖正在从硬件供给转向“算力即服务”。谷歌、AWS和Cerebras都以调用次数或每百万Tokens成本计费。客户关注的不再是使用哪种芯片,而是谁能提供更可预测、更具性价比的AI算力生产力。
未来的AI基础设施将形成“异构共生”的格局。GPU仍将在科研和模型训练领域保持优势,而TPU、LPU、WSE等专设架构将成为AI推理的中坚力量。竞争带来的最大红利是推理成本的下降与创新门槛的降低。AI不再只是巨头的游戏,而会成为更多创业者可负担的技术底座。
英伟达仍是算力世界的重要玩家,但它必须学会在更复杂的生态中共生。未来的竞争不再是硬件堆叠的较量,而是经济效率、生态整合与开放创新的较量。在这场从训练到推理的时代转变中,AI的计算模式正迈入一个更加开放而多元的阶段。对于英伟达,这既是挑战,也是机会;对于整个AI产业而言,这或许是一次重塑未来的真正起点。
大牛证券提示:文章来自网络,不代表本站观点。